Durante los últimos años, gran parte de la conversación sobre inteligencia artificial y ciberseguridad se concentró en una pregunta bastante cómoda:
¿Cómo puede la IA ayudarnos a defender mejor nuestras organizaciones?
SOC más rápidos. Detección más precisa. Análisis automatizado. Respuesta ante incidentes. Generación de código. Automatización de tareas.
Pero en 2026 la pregunta empieza a cambiar.
Y es bastante menos cómoda:
¿Quién está protegiendo a la IA que ya opera dentro de nuestra organización?
La diferencia parece semántica, pero no lo es.
Los copilotos y agentes de IA están dejando de ser herramientas que simplemente responden preguntas o resumen información. Cada vez más, pueden consultar bases de datos, escribir y ejecutar código, acceder a documentos, modificar configuraciones, interactuar con aplicaciones empresariales y tomar decisiones que desencadenan acciones reales.
NIST ya identifica precisamente esta característica —la capacidad de los agentes para interactuar con datos, herramientas y aplicaciones y actuar de manera autónoma— como una fuente de nuevos desafíos de seguridad que requieren adaptar los controles tradicionales.
Y aquí aparece el problema:
un agente que puede actuar necesita ser protegido como cualquier otra identidad con privilegios dentro de la organización.
Pero con una diferencia importante.
Un usuario puede tardar minutos en cometer un error.
Un agente puede hacerlo en segundos.
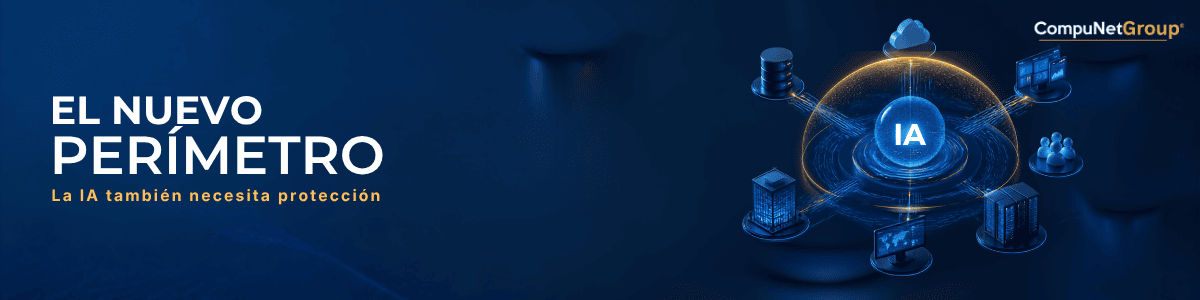
EL PERÍMETRO CAMBIÓ
Durante décadas pensamos el perímetro de seguridad de una organización alrededor de elementos relativamente conocidos:
- usuarios;
- dispositivos;
- servidores;
- aplicaciones;
- redes;
- datos.
Por eso construimos firewalls, antivirus, EDR, DLP, IAM, SIEM y SOC.
Pero ahora apareció otro actor:
el agente de inteligencia artificial.
Y no es simplemente otra aplicación.
Un agente puede interpretar lenguaje natural, recibir información de fuentes externas, combinar ese contexto con información interna, utilizar herramientas y ejecutar acciones.
Eso cambia radicalmente el modelo de amenaza.
Imaginemos un agente encargado de apoyar al área financiera.
Tiene acceso a correos, documentos, ERP y determinados procesos de aprobación.
Un atacante no necesariamente necesita vulnerar directamente el ERP.
Puede intentar manipular la información que el agente consume.
Si consigue que el agente interprete una instrucción maliciosa como parte legítima de su contexto, el problema deja de ser un mensaje incorrecto.
Ahora tenemos una identidad con permisos ejecutando una decisión equivocada.
Y eso es bastante más serio.
1. PROJECT INJECTION: LA NUEVA FRONTERA DE ATAQUE
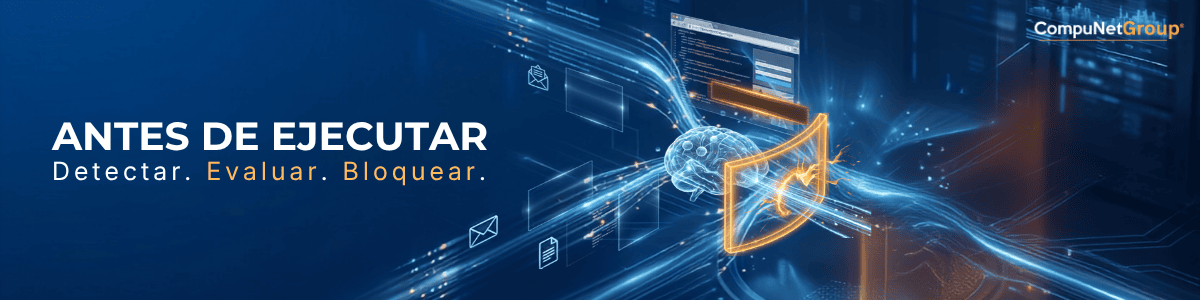
La inyección de prompts se ha convertido en uno de los problemas centrales de seguridad para los sistemas basados en IA.
Cisco la ha descrito directamente como “la nueva SQL injection”, precisamente porque explota una característica estructural de los modelos: la dificultad para distinguir de manera completamente confiable entre instrucciones legítimas y contenido que simplemente debería ser tratado como datos.
El problema se vuelve especialmente delicado cuando hablamos de inyección indirecta.
Un agente puede recibir información desde:
- Un correo electrónico;
- Una página web;
- Un documento PDF;
- Un repositorio de código;
- Un sistema de tickets;
- Una base documental;
- Una herramienta externa.
Ese contenido puede contener instrucciones diseñadas para cambiar el comportamiento del agente.
Y el agente puede no saber que esas instrucciones son maliciosas.
EL ATACANTE NO NECESITA CONVENCER AL USUARIO. NECESITA CONVENCER AL AGENTE.
La investigación publicada por NIST durante 2026 confirma que el agent hijacking, o secuestro de agentes mediante inyección indirecta, puede producir acciones no deseadas como la extracción de información sensible o la ejecución de código.
Y existe otro detalle particularmente incómodo: la persistencia.
En una evaluación publicada por Anthropic sobre agentes de coding, la tasa de éxito de ataques de inyección indirecta fue de 4,7% con un intento, 33,6% con diez intentos y 63% cuando el atacante podía realizar cien intentos.
La lectura importante no es solamente el 4,7%.
Es esta:
un atacante persistente cambia las probabilidades.
Por eso una defensa que funciona razonablemente bien ante un único intento puede resultar insuficiente frente a un adversario que puede probar, adaptar y volver a intentar.
2. LA FUGA DE INFORMACIÓN YA NO NECESITA UN ATACANTE SOFISTICADO
Existe otra amenaza mucho más cotidiana.
La propia IA puede convertirse en una vía de exposición de información.
El ejemplo clásico es sencillo:
Un empleado recibe un contrato confidencial y decide utilizar una herramienta pública de IA para resumirlo.
No necesariamente existe una intención maliciosa.
No hay malware.
No hay explotación de una vulnerabilidad.
No hay un atacante detrás del teclado.
Simplemente existe una persona intentando trabajar más rápido.
El problema es que la organización puede no saber:
- Qué información se está enviando;
- A qué modelo;
- Bajo qué condiciones;
- Dónde queda almacenada;
- Quién puede acceder posteriormente;
- Qué políticas aplican sobre esos datos.
Ahora llevemos el mismo escenario a un agente.
El agente no necesita que un empleado copie y pegue manualmente el documento.
Puede acceder automáticamente a información de clientes, contratos, correos o sistemas internos.
Y puede mover esa información entre diferentes servicios.
La velocidad de la automatización transforma un problema puntual en un problema potencialmente masivo.
3. SHADOW AI: CUANDO LA ORGANIZACIÓN DESCUBRE LA IA DESPUÉS DE QUE YA ESTÁ FUNCIONANDO
Las organizaciones ya aprendieron una lección con el Shadow IT.
Los usuarios adoptan herramientas antes de que las políticas alcancen a regularlas.
Con la inteligencia artificial está ocurriendo algo similar.
Chatbots, asistentes de programación, extensiones de navegador, herramientas de transcripción, servicios de generación de contenido y agentes especializados pueden incorporarse al trabajo diario sin pasar necesariamente por un proceso formal de seguridad.
Eso crea un problema de visibilidad.
No se puede proteger aquello que la organización no sabe que existe.
Pero existe una segunda dimensión todavía más importante:
¿Qué permisos tiene esa IA?
NIST está trabajando específicamente en este problema: cómo identificar, autorizar, auditar y establecer mecanismos de responsabilidad para agentes de software y agentes de IA.
La pregunta que deberíamos hacerle a un agente no es solamente:
“¿Qué modelo utiliza?”
También deberíamos preguntar:
“¿Qué puede hacer ese modelo cuando se equivoca?”
Porque un agente con acceso a información sensible y capacidad de ejecutar acciones puede convertirse, en la práctica, en una nueva identidad privilegiada.
EL PROBLEMA CON CONFIAR SOLAMENTE CON CONTROLES TRADICIONALES
Aquí aparece una de las principales confusiones.
No significa que el firewall haya dejado de ser útil.
Tampoco que un SIEM, un EDR o un DLP tradicional sean inútiles.
El problema es diferente:
fueron diseñados para resolver problemas distintos.
- Un firewall puede controlar comunicaciones.
- Un EDR puede detectar comportamientos sospechosos en un endpoint.
- Un DLP puede identificar determinados patrones de información sensible.
- Un SIEM puede correlacionar eventos.
Pero ninguno de ellos, por sí solo, necesariamente entiende la intención que existe detrás de una interacción entre: usuario → agente → modelo → contexto → herramienta → acción.
Ese es el nuevo recorrido que debemos proteger.
Y NIST coincide en algo fundamental: los principios tradicionales de ciberseguridad siguen siendo relevantes, pero necesitan ser adaptados para responder a los riesgos específicos de los agentes.
ENTONCES, ¿QUÉ DEBERÍA PROTEGER UNA ORGANIZACIÓN?
La respuesta no es comprar “otro firewall”.
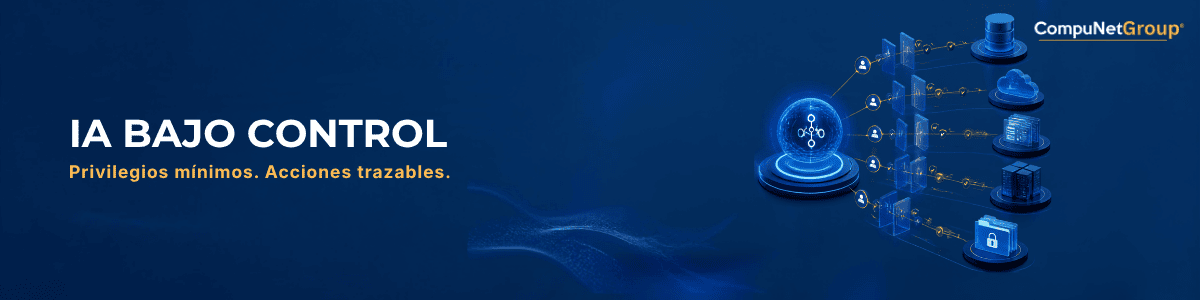
La respuesta es construir una nueva capa de control alrededor de la IA.
Podemos pensarla en cuatro niveles.
Capa 1 — Control de las acciones del agente
El agente no debería tener libertad absoluta para ejecutar cualquier acción que su modelo considere apropiada.
Las acciones críticas necesitan controles previos.
Por ejemplo:
Permitir.
La acción es coherente con la política y el contexto.
Advertir.
La acción puede ser legítima, pero requiere una revisión adicional.
Bloquear.
La acción excede las capacidades permitidas para ese agente.
Esta lógica funciona como un circuit breaker.
No intenta predecir perfectamente todo lo que hará la IA.
Busca algo mucho más práctico: limitar qué puede hacer cuando se equivoca.
Y eso es fundamental porque no podemos asumir que un modelo será infalible frente a un atacante determinado.
De hecho, NIST publicó en 2026 investigación que refuerza la necesidad de un enfoque continuo de evaluación y actualización, en lugar de asumir que un conjunto fijo de controles será suficiente frente a ataques adaptativos.
Capa 2 — El agente debe tener identidad y privilegios
Si una persona tiene acceso privilegiado a sistemas críticos, esperamos que tenga:
- Identidad;
- Autenticación;
- Permisos definidos;
- Privilegio mínimo;
- Trazabilidad;
- Controles de acceso;
- Monitoreo.
¿Por qué debería ser diferente para un agente?
No debería.
Cada agente debe tener una identidad claramente definida y permisos específicos.
No debería poder acceder a todo “porque quizás algún día lo necesite”.
No debería reutilizar credenciales personales.
No debería tener acceso permanente a sistemas críticos.
Y, especialmente:
Si no permitirías que un usuario ejecute esa acción como administrador, probablemente tampoco deberías permitir que un agente la ejecute sin controles.
La discusión sobre identidad y autorización de agentes ya está siendo abordada formalmente por NIST, incluyendo identificación, autorización, auditoría y no repudio.
Capa 3 — Gobernanza, DLP y control del Shadow AI
La organización necesita saber qué IA utiliza.
Pero también necesita saber: qué información entra y qué información sale.
Eso significa establecer políticas para:
- Herramientas autorizadas;
- Modelos aprobados;
- Información que puede procesarse;
- Información que nunca debe salir;
- Agentes permitidos;
- Integraciones autorizadas;
- Almacenamiento de información;
- Uso de datos sensibles.
Aquí el DLP sigue siendo relevante, pero debe evolucionar.
Ya no basta con proteger archivos almacenados.
Hay que considerar también:
prompts, respuestas, contexto, documentos recuperados, herramientas utilizadas y acciones ejecutadas por agentes.
Y existe una dimensión adicional:
La procedencia del modelo importa.
No basta con saber que una aplicación “usa IA”.
La organización debería conocer qué modelo utiliza, quién lo desarrolla, qué proveedores participan en la cadena y qué componentes intervienen en el procesamiento.
La cadena de suministro de IA también es parte de la superficie de ataque.
Capa 4 — Red Teaming para IA
Hay una regla bastante simple en ciberseguridad: si no lo pruebas tú, eventualmente alguien más lo probará.
Eso también aplica a los agentes.
El red-teaming de IA busca precisamente poner a prueba el comportamiento del sistema antes de que lo haga un adversario.
La evaluación debería intentar responder preguntas como:
- ¿Puede un agente ser manipulado por contenido externo?
- ¿Puede acceder a información que no necesita?
- ¿Puede ejecutar herramientas fuera de su propósito?
- ¿Puede modificar sistemas críticos?
- ¿Puede revelar información sensible?
- ¿Puede mantener una acción peligrosa después de recibir nueva información?
- ¿Qué ocurre cuando recibe instrucciones contradictorias?
- ¿Qué pasa cuando un atacante insiste?
NIST ha impulsado durante 2026 evaluaciones y ejercicios de red-teaming específicamente orientados a la seguridad de agentes, justamente porque las pruebas tradicionales no capturan completamente este nuevo escenario.
NO SE TRATA DE DETENER LA IA
Este punto es importante.
La respuesta no debería ser: “Entonces no usemos agentes.”
Eso sería equivalente a decir que, como existen vulnerabilidades en las aplicaciones, dejemos de utilizar software.
El objetivo es otro:
Permitir autonomía, pero con límites.
Una organización puede utilizar agentes para automatizar procesos.
Puede permitirles consultar información.
Puede conectarlos a herramientas.
Puede permitirles tomar decisiones.
Pero debe establecer claramente: qué pueden hacer, qué nunca pueden hacer y qué acciones necesitan supervisión.
La autonomía sin control no es innovación.
Es simplemente delegación de riesgo a una máquina.
UNA HOJA DE RUTA PRÁCTICA
No es necesario implementar toda esta arquitectura de un día para otro.
Un enfoque razonable puede comenzar con tres fases.
01 — Descubrir
Primero hay que saber qué existe.
Inventariar:
- Herramientas de IA;
- Modelos utilizados;
- Agentes;
- Integraciones;
- Fuentes de datos;
- Permisos;
- Credenciales;
- Información procesada.
Incluyendo aquello que nunca pasó por el área de TI.
Shadow AI también forma parte del inventario de riesgo.
02 — Contener
Una vez que sabemos qué existe, podemos comenzar a gobernarlo.
Definir:
- Política de uso de IA;
- Herramientas autorizadas;
- Clasificación de información;
- Privilegios mínimos;
- Controles de acceso;
- Reglas de DLP;
- Supervisión de acciones críticas.
Esta etapa puede generar una reducción significativa del riesgo sin requerir una transformación tecnológica completa.
03 — Validar
Finalmente, hay que asumir que los controles también pueden fallar.
Por eso necesitamos pruebas periódicas.
Red teaming.
Simulación de ataques.
Evaluación de agentes.
Revisión de permisos.
Monitoreo continuo.
Y actualización de controles.
Porque una arquitectura de seguridad para IA que se prueba una vez y luego se abandona probablemente terminará siendo tan obsoleta como la amenaza que intentaba detener.
LA PREGUNTA QUE DEBERÍA LLEGAR AL DIRECTORIO
Hasta hace poco, la conversación sobre IA podía parecer exclusivamente tecnológica.
Ya no.
Cuando un agente puede acceder a información financiera, modificar infraestructura, consultar bases de datos, escribir código o ejecutar procesos de negocio, estamos hablando de riesgo operacional, reputacional, regulatorio y estratégico.
Por eso la pregunta para un directorio no debería ser:
“¿Estamos usando inteligencia artificial?”
Probablemente la respuesta ya sea sí.
La pregunta debería ser:
“¿Sabemos qué puede hacer nuestra IA, con qué información, con qué permisos y qué sucede si toma una decisión equivocada?”
Y existe una pregunta todavía más incómoda:
“¿Quién vigila a nuestros agentes cuando nosotros no estamos mirando?”
EL NUEVO PERÍMETRO NO ES UNA CAJA. ES UNA DECISIÓN.
La seguridad de la IA no consiste únicamente en proteger el modelo.
Consiste en proteger todo lo que ocurre alrededor del modelo.
Los datos que recibe.
Las instrucciones que interpreta.
Las herramientas que utiliza.
Las identidades que emplea.
Los sistemas a los que accede.
Las decisiones que toma.
Y las acciones que ejecuta.
El firewall tradicional seguirá teniendo su lugar.
El SOC seguirá teniendo su lugar.
El EDR, el DLP, el IAM y el resto de la arquitectura de ciberseguridad también.
Pero el perímetro se está expandiendo.
Porque ahora tenemos sistemas capaces de interpretar información y actuar sobre el mundo digital.
Y cuando el software empieza a tomar decisiones, proteger la red ya no es suficiente. También hay que proteger la decisión.
En CompuNetGroup entendemos este desafío como una evolución natural de la ciberseguridad gestionada: descubrir el uso real de IA, identificar Shadow AI, controlar privilegios, establecer políticas de gobierno, proteger los flujos de información y someter a los agentes a pruebas de seguridad antes de que un atacante lo haga por nosotros.
Porque la pregunta ya no es si la inteligencia artificial va a entrar en las organizaciones.
Ya entró.
La pregunta es si entró con los controles adecuados.
¿QUIERES SABER QUÉ TAN EXPUESTA ESTÁ TU ORGANIZACIÓN FRENTE AL USO DE IA?
Conversemos sobre cómo identificar tus agentes, evaluar sus permisos, descubrir Shadow AI y construir una estrategia de seguridad para la nueva generación de sistemas autónomos.
CompuNetGroup — Seguridad Digital Gestionada
¿Listo para dar el salto? Contáctanos
CompunetGroup